W „2001: Odysei kosmicznej” HAL 9000 zapewnia dziennikarza BBC, że żaden komputer serii 9000 nigdy nie popełnił błędu. Kilka scen później zgłasza Dave’owi Bowmanowi, że moduł AE-35 w ciągu 72 godzin ulegnie awarii w stu procentach, i nazywa tę liczbę całkowicie wiarygodną. Bowman sprawdza moduł i nie znajduje usterki, a bliźniaczy komputer 9000 w centrum kontroli misji ocenia, że HAL się myli. Film Stanleya Kubricka wszedł do kin w 1968 roku i w jednym wątku opisał problem, który dziś ma nazwę: model bez skalibrowanej pewności.
Przypomniałem sobie tę scenę 25 września, kiedy zapytałem Jeva, jaką oś powinien mieć ten tekst. Jev to model decyzyjny firmy TypeSafe AI. Nie pisze odpowiedzi, tylko zwraca decyzję razem z rozkładem prawdopodobieństwa. Dałem mu trzy warianty. Dwa pierwsze dostały 0,53 i 0,46, a pewność całej odpowiedzi wyniosła 0,30. Po ludzku: obawiam się, że nie wiem, Jacku. Takiej odpowiedzi od HAL-a Dave się nie doczekał.
Ilustracje we wpisie wygenerowała AI na podstawie zdjęcia autora.
Tydzień, w którym wróciło uczenie maszynowe
TypeSafe AI ujawnił się publicznie 15 września. W ciągu kilku dni wokół Jeva powstał cały ekosystem i to on interesuje mnie bardziej niż sam model. Laya, otwarty model o tym samym kontrakcie (wybór z listy, ocena na skali, prawdopodobieństwo prawdziwości zdania), działa na enkoderach ModernBERT i mmBERT, czyli na następcach BERT-a z 2018 roku. Powstał już jej port na MLX, który działa na Macu bez chmury. Together AI opublikował poradnik douczania własnego klasyfikatora w stylu Jeva na modelu Qwen3.5 4B, a autorzy Layi udostępnili notatnik do douczania na darmowych kartach graficznych w Kaggle.
Kto robił data science przed ChatGPT, rozpozna ten zestaw bez trudu: enkoder, głowica klasyfikacyjna, kalibracja, próg decyzyjny, zbiór testowy. Od premiery ChatGPT coraz więcej decyzji oddawaliśmy modelom, które piszą. W ciągu tygodnia rynek przypomniał sobie, że decyzja i tekst to dwa różne zadania, a do pierwszego od dawna mamy lepsze narzędzia.
Jak używam Jeva na co dzień
Od 20 września Jev jest u mnie drugą opinią. Przy każdej ocenie, którą wydaje mój asystent AI, na przykład czy wpis jest zrozumiały albo który wariant wybrać, obok stoi ocena Jeva z pełnym rozkładem, a każdy rozjazd trafia do rejestru. Do API w USA wysyłam wyłącznie treści publiczne albo syntetyczne. Dane klientów nie opuszczają naszej infrastruktury.
Przy wpisie o SAPMAP Jev ocenił zrozumiałość dla czytelnika nietechnicznego niemal po równo: 0,51 dla odpowiedzi „zrozumiały dla decydenta” i 0,47 dla „częściowo zrozumiały”. Dopisaliśmy objaśnienie, czym jest RFC. Przy ocenie pilności jednego z tematów zwrócił wynik 1,35 przy pewności 0,03, bo nie potrafił rozstrzygnąć między „w tym kwartale” a „w tym miesiącu”. Sama etykieta powiedziałaby „pilność średnia” i nikt by nie zauważył, że model zgaduje.
Test w naszym laboratorium
Kilka pojedynczych wywołań to anegdota, więc 25 września przygotowaliśmy test. Trzydzieści syntetycznych zgłoszeń po polsku i jedno pytanie: który zespół ma przejąć sprawę - SAP, cyberbezpieczeństwo, automatyzacja czy nikt, bo to poza zakresem. Wśród zgłoszeń umieściliśmy trzy pułapki znane nam z wyszukiwania przetargów, gdzie SAP oznacza System Alarmowy Pożaru, oraz cztery sprawy celowo niejednoznaczne, na przykład robota UiPath, który przestał działać po aktualizacji SAP GUI. Te same pytania poszły do Jeva w chmurze i do dwóch wersji Layi uruchomionych lokalnie na Macu z procesorem M4 Max. Dlaczego lokalny sprzęt ma dla nas znaczenie, pisałem przy okazji Mac Studio jako maszyny do POC.
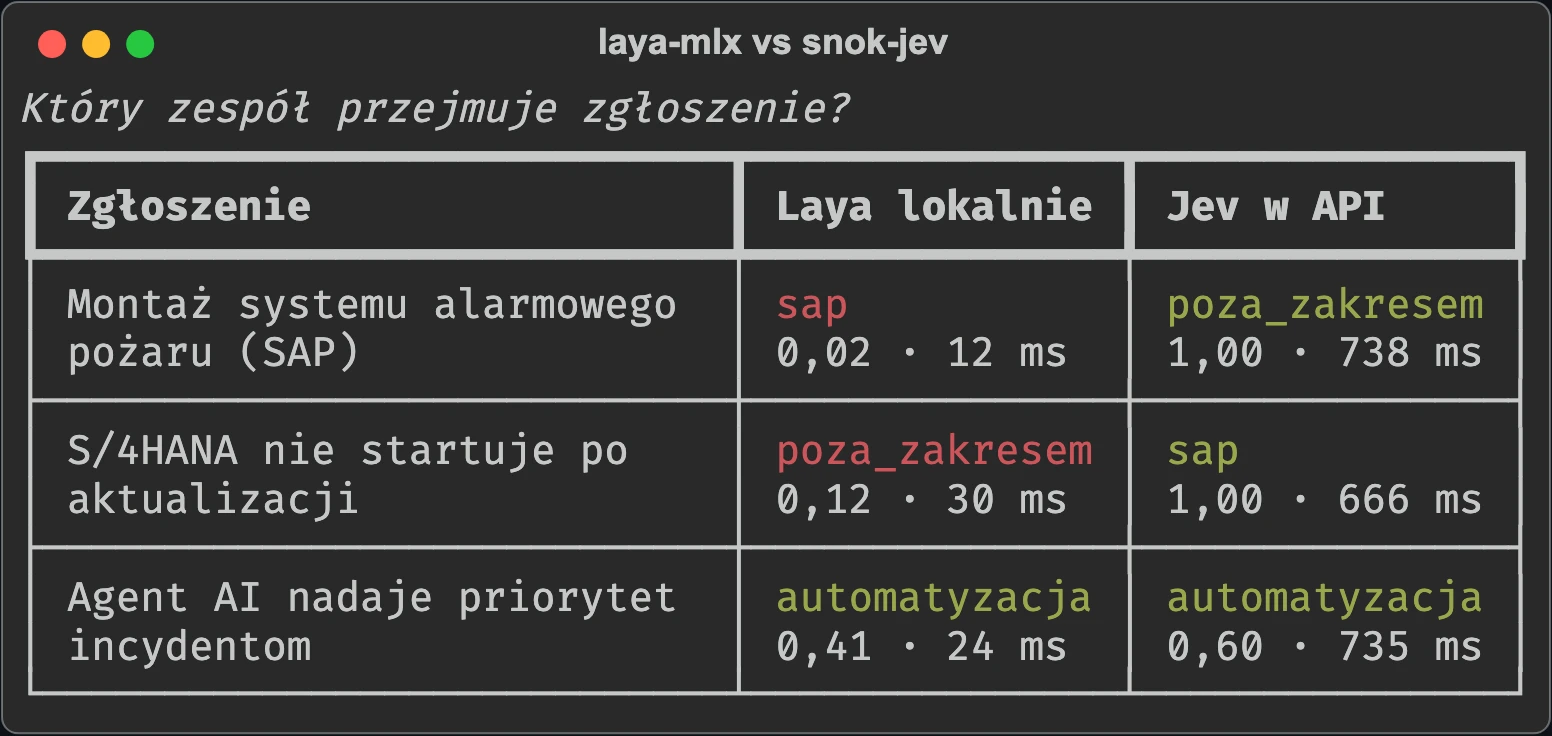
Jev rozstrzygnął poprawnie wszystkie 26 jednoznacznych zgłoszeń i rozpoznał wszystkie trzy pułapki, a mediana czasu odpowiedzi wyniosła około 0,66 sekundy. Średnia pewność przy zgłoszeniach jasnych wyniosła 1,00, a przy niejednoznacznych 0,73, więc spada tam, gdzie powinna. Wszystkie 50 wywołań, razem 24 387 tokenów wejścia, kosztowały według cennika producenta około 0,001 USD.
Wielojęzyczna Laya bez douczania trafiła w 12 z 26 zgłoszeń i nie rozpoznała żadnej pułapki: wszystkie trzy alarmy pożarowe odesłała do zespołu SAP albo cyberbezpieczeństwa. Odpowiada za to w 8 milisekund, bez wysyłania czegokolwiek poza komputer. Ciekawsze jest to, jak się myli. Przy trafnych odpowiedziach jej średnia pewność wynosi 0,74, a przy błędnych 0,19. Model słabo zgaduje, ale dobrze wie, kiedy zgaduje. Z jednym zastrzeżeniem: autorzy Layi piszą wprost, że wersja wielojęzyczna nie ma dopasowanej kalibracji, więc te liczby opisują model przed strojeniem.
Angielska Laya na polskim tekście trafiła w 13 z 26 zgłoszeń przy pewności około 0,11 przy każdym z nich, czyli nie udawała, że rozumie język.
Próg, który raz działa, a raz nie
Najwięcej nauczyło mnie jedno zgłoszenie: „Agent AI ma czytać zgłoszenia o incydentach i nadawać im priorytet”. Wysłałem je do Jeva 21 razy. Odpowiedź za każdym razem była ta sama, automatyzacja, ale pewność wahała się od 0,45 do 0,63. Gdyby w procesie stał próg 0,60, ten sam tekst trzy razy przeszedłby automatycznie, a osiemnaście razy trafiłby do człowieka. Lokalna Laya na tym samym zgłoszeniu za każdym razem zwraca identyczne 0,41.
Podobny wniosek opisał na LinkedIn praktyk UiPath, który porównał Jeva z agentem w Maestro Flow na dziesięciu sprawach: model zwrócił pewność 1,00 w ośmiu z nich, więc bramka „poniżej 0,60 do człowieka” prawie nigdy się nie uruchomiła. Progu przekazania do człowieka nie ustawiamy na wyczucie. Wyznaczamy go na zbiorze walidacyjnym, patrząc na rozkład pewności i na koszt każdego błędu. Autorzy Layi ujmują to w dokumentacji tak: próg jest decyzją, którą podejmujemy na podstawie zmierzonej trafności na własnych danych, a nie cechą modelu. To zasada z każdego podręcznika uczenia maszynowego ostatnich dwudziestu lat.
Kaskada, czyli stary pomysł w nowym ogródku
Z tych liczb wychodzi architektura, którą zespoły data science stosowały długo przed modelami językowymi: kaskada. Tani, lokalny model decyduje tam, gdzie jest pewny, a resztę przekazuje dalej. W naszym teście Laya z progiem 0,5 rozstrzygnęła lokalnie 12 zgłoszeń z 30 i pomyliła się w jednym. Pozostałe 18 trafiło do Jeva. Wynik całości to 29 poprawnych decyzji na 30, a na zewnątrz wyszło 18 zgłoszeń zamiast 30. Przy danych klienta ten podział waży więcej niż milisekundy, bo materiałów objętych NDA w ogóle nie wysyłamy do API w USA.
Autorzy Layi podają, że douczenie na danych z konkretnej domeny poprawia trafność ich modelu na benchmarku decyzji typowanych z 0,362 do 0,766. To również stara prawda: własne, dobrze opisane dane wygrywają z modelem ogólnym. Zbiór z etykietami trzeba jednak zbudować samemu i tej pracy żaden nowy model za nas nie wykona.
Jev w ogródku rozwiązań
U mnie Jev dołącza do ogródka, w którym każde narzędzie ma swoją grządkę. Wyrażenia regularne zostają na stałe jako plan awaryjny: gdy API nie odpowie, system wraca do reguł, zamiast stanąć. Lokalne modele obsługują dane, które nie mogą opuścić infrastruktury klienta. W tym samym kierunku budujemy u klientów LLM on-premise w SNOK, także na sprzęcie takim jak Lenovo ThinkStation PGX. Duży model językowy zostaje przy pisaniu i rozumowaniu w wielu krokach. Jev dostaje drobne decyzje pomiędzy nimi: klasyfikację, wybór ścieżki, bramki jakości. Zasada jest prosta: model proponuje gałąź, a kod decyduje, czy wolno ją wykonać. Publikacja, płatność i usunięcie danych zawsze przechodzą przez twardą kontrolę.
Na maszynie laboratoryjnej, na której eksperymentujemy z agentem Hermes, czeka plan dla wyszukiwania przetargów. Jev ma najpierw pracować w trybie cienia, czyli decydować i tylko zapisywać decyzje, a korpus dzielimy na część do strojenia i zamrożoną część testową, z wymaganym recall 0,95. Uczciwie licząc, potwierdzenie takiego wyniku zajmie trzy do czterech miesięcy. Na razie to plan, nie wdrożenie.
HAL nie potrafił powiedzieć „nie wiem”. Jev i Laya potrafią, a pewność 0,30 jest dla nich pełnoprawną odpowiedzią, z którą kod może coś zrobić.
Gdzie w Waszych systemach model językowy podejmuje dziś decyzję „tak albo nie”? Jestem ciekaw, czy u Was też jest takich miejsc więcej, niż zakładaliście.
Źródła
- TypeSafe AI, strona produktu i dokumentacja API Jev - https://typesafe.ai/, https://docs.typesafe.ai/api.md (dostęp 25.09.2026)
- Laya, repozytorium i README z wynikami benchmarku decyzji typowanych oraz uwagą o kalibracji - https://github.com/NandhaKishorM/laya (dostęp 25.09.2026)
- laya-mlx, port Layi na Apple MLX - https://github.com/mizorewww/laya-mlx (dostęp 25.09.2026)
- AI IDE List, „What Is Laya-MLX?”, 20.09.2026 - https://aiidelist.com/blog/what-is-laya-mlx (dostęp 25.09.2026)
- Together AI, tev1 i poradnik „How to train your own Jev” - https://github.com/togethercomputer/tev1, https://www.together.ai/blog/how-to-train-your-own-jev (dostęp 25.09.2026)
- Pomiar Jev i agenta UiPath w Maestro Flow, wpis na LinkedIn - https://www.linkedin.com/feed/update/urn:li:activity:7508514827871375360/ (dostęp 25.09.2026)
- Test własny SNOK, 25.09.2026: 30 syntetycznych zgłoszeń, Jev jev-1.13.0 przez API, laya-mlx 0.2.0 na Macu z M4 Max
- „2001: Odyseja kosmiczna”, reż. Stanley Kubrick, 1968