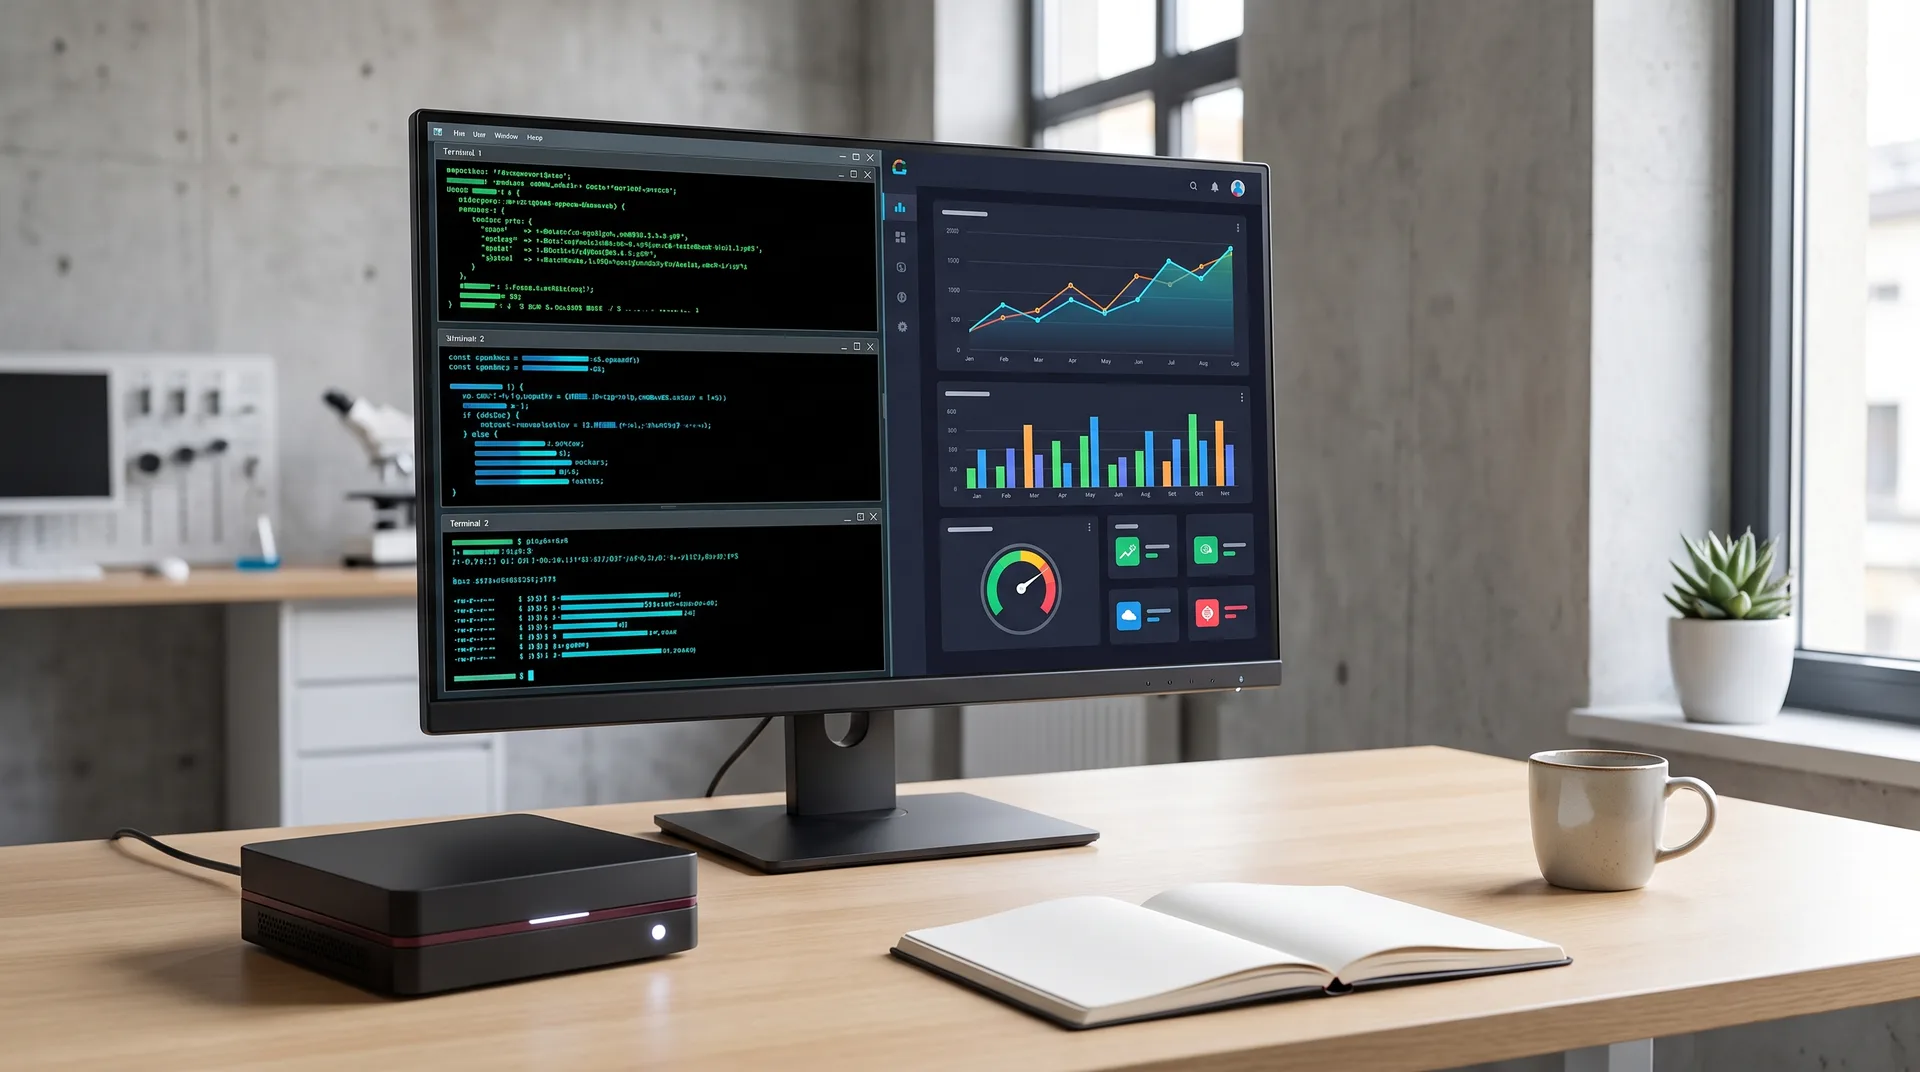
Rzadko piszę o sprzęcie. Tym razem robię wyjątek, bo przez nasz lab przeszła maszyna, która zmienia sposób myślenia o firmowym AI - i zdążyliśmy ją porządnie przećwiczyć, zanim pojechała dalej, do klienta.
Mowa o Lenovo ThinkStation PGX: korporacyjnym wariancie klasy urządzeń zbudowanych na superchipie NVIDIA GB10 Grace Blackwell, czyli tej samej rodziny co NVIDIA DGX Spark. Z zewnątrz wygląda jak elegancki mini-pecet. W środku jest coś, co jeszcze dwa lata temu wymagało szafy serwerowej: komputer zaprojektowany wyłącznie pod rozwój i uruchamianie sztucznej inteligencji.
Co siedzi w środku
Konfiguracja, którą testowaliśmy, wygląda tak (pełna specyfikacja: Lenovo Press):
- superchip NVIDIA GB10 Grace Blackwell - CPU i GPU w jednym układzie,
- 20 rdzeni ARM (10x Cortex-X925 + 10x Cortex-A725),
- GPU NVIDIA Blackwell z Tensor Cores 5. generacji,
- 128 GB pamięci LPDDR5X unified - współdzielonej przez CPU i GPU, o przepustowości 273 GB/s,
- dysk NVMe do 4 TB z szyfrowaniem sprzętowym,
- sieć 10 GbE plus karta ConnectX-7 i Wi-Fi 7,
- system NVIDIA DGX OS (Ubuntu na ARM64),
- a wszystko zasilane zasilaczem o mocy 240 W - mniej, niż potrafi pobrać jedna gamingowa karta graficzna.
Kluczowa liczba to 128 GB pamięci unified. W klasycznej stacji roboczej model językowy musi zmieścić się w pamięci karty graficznej, a to zwykle 24-48 GB. Tutaj CPU i GPU dzielą jedną, wspólną pulę - więc na maszynie wielkości książki uruchamiacie modele, które dotąd wymagały serwera z kartami za kilkaset tysięcy złotych.
Co na nim uruchomiliśmy
Nie testowaliśmy benchmarkami dla samych benchmarków. Postawiliśmy kompletne środowisko pracy, takie, jakie realnie stawia się u klienta:
- backend wnioskowania (Ollama i vLLM) serwujący modele przez standardowy, zgodny z OpenAI endpoint,
- Hermes Agent od Nous Research - open-source’owy agent, który łączy się z tym endpointem, wykonuje zadania narzędziami i buduje własną pamięć,
- zestaw modeli lokalnych: gpt-oss-120b jako flagowy generalista, Qwen3-Coder 30B do kodu i pracy agentowej oraz gpt-oss-20b do szybkich, tanich zadań.
Największe wrażenie robi pierwsza z tych pozycji. Model o 120 miliardach parametrów - klasy, która jeszcze niedawno była zarezerwowana dla chmury - działa lokalnie, płynnie i z sensownym czasem odpowiedzi (realna prędkość zależy przy tym mocno od silnika wnioskowania - zoptymalizowany stos potrafi być kilkukrotnie szybszy od ustawień domyślnych). W architekturze Mixture-of-Experts na każdy token aktywna jest tylko część parametrów, więc mimo rozmiaru model w kwantyzacji MXFP4 zajmuje około 60-65 GB i zostawia zapas na długi kontekst.
Trzy lekcje z testów
Po pierwsze: MoE bije dense. Duże modele o gęstej architekturze (na przykład Llama 70B) mieszczą się w pamięci bez problemu, ale w pojedynczej rozmowie są wolne - przepustowość 273 GB/s to naturalna granica, co potwierdzają także publiczne benchmarki. Modele Mixture-of-Experts omijają tę granicę z gracją. Dobór architektury modelu ma na tej maszynie większe znaczenie niż sam rozmiar.
Po drugie: to maszyna dla agentów, nie dla jednego czatu. Przewaga GB10 ujawnia się przy wielu równoległych zapytaniach - dokładnie tak pracują agenty AI i pipeline’y przetwarzania dokumentów. W trybie wsadowym urządzenie osiąga wielokrotnie wyższą łączną przepustowość niż w pojedynczej rozmowie. Jeśli planujecie wdrażać agentów na produkcję, to jest sprzęt skrojony pod ten scenariusz.
Po trzecie: pełny offline naprawdę działa. Cały łańcuch - model, agent, narzędzia, pamięć - pracuje bez jednego pakietu wysłanego do internetu. Dla firm z danymi pod NDA, danymi osobowymi albo wymaganiami regulacyjnymi (NIS2, DORA) to nie jest ciekawostka, tylko odpowiedź na pytanie, które słyszymy najczęściej: “jak korzystać z AI, żeby nasze dane nie wyjechały z organizacji?”. Pisaliśmy o tym podejściu przy okazji fabryki AI dla SAP bez chmury - PGX to ten sam kierunek, tylko w formacie, który stawia się na biurku w godzinę.
Dla kogo to jest
Po tych testach widzimy trzy naturalne zastosowania:
- Poufne AI na własnych danych. Analiza dokumentów, kodu i danych, które nie mogą opuścić organizacji - lokalny model plus RAG na wewnętrznej bazie wiedzy.
- Środowisko deweloperskie zespołów AI. Prototypowanie agentów i pipeline’ów bez licznika kosztów API - po zakupie sprzętu koszt krańcowy wnioskowania wynosi zero.
- Pierwszy krok do prywatnej infrastruktury AI. Zanim zainwestujecie w pełną prywatną chmurę pod obciążenia enterprise, na PGX sprawdzicie na realnych danych, czy lokalne modele udźwigną Wasze przypadki użycia.
Dla pełnego obrazu - ograniczenia: to nie jest maszyna do trenowania dużych modeli ani do zastąpienia chmury tam, gdzie potrzebujecie najwyższej jakości frontier models. To urządzenie do wnioskowania, prototypowania i pracy agentowej - i w tej roli jest dziś w naszej ocenie najciekawszą propozycją w swojej klasie cenowej.
Werdykt
Egzemplarz, który testowaliśmy, pojechał już do klienta - i szczerze mówiąc, trochę nam go brakuje. Maszyn, które w tym rozmiarze i przy poborze 240 W serwują modele klasy 120B, po prostu do tej pory nie było.
Jeżeli zastanawiacie się, jak mogłoby wyglądać takie środowisko u Was - od doboru sprzętu, przez modele, po agentów zintegrowanych z Waszymi procesami - jako partner Platinum Lenovo pomagamy przejść tę drogę od testu do produkcji. Napiszcie do nas, pokażemy to na żywo.