W skrócie
- O tym, czy model lokalny w ogóle się uruchomi, decyduje pojemność pamięci zunifikowanej, a o tym, jak szybko pisze - jej przepustowość. Nazwa układu jest dopiero trzecia.
- Wielkość modelu to liczba parametrów razy precyzja zapisu: Qwen3.8-27B zajmuje około 56 GB w formacie BF16 i około 16 GB po kwantyzacji do 4 bitów, a do tego dochodzi pamięć na kontekst.
- Według apple.com/pl z 7 listopada 2026 roku Mac Studio z dyskiem 1 TB kosztuje 26 999 zł z M5 Max i 128 GB, 47 999 zł z M5 Ultra i 256 GB oraz 111 999 zł z 512 GB, a Lenovo ThinkStation PGX ma 128 GB pamięci o przepustowości 273 GB/s.
- Przy krótkiej odpowiedzi qwen3-coder 30B pisał na MacBooku Pro z M4 Max około 71 tokenów na sekundę, a na Lenovo ThinkStation PGX około 78, a przy długiej przewaga PGX rosła - przy modelu MoE liczyły się moc obliczeniowa i oprogramowanie.
- W SNOK MacBook służy do testów modeli, a dwa Lenovo ThinkStation PGX obsługują zadania ciągłe: kodowanie, analizę przetargów i testy bezpieczeństwa agentów AI; dane klienta objęte NDA przetwarzamy w jego środowisku.
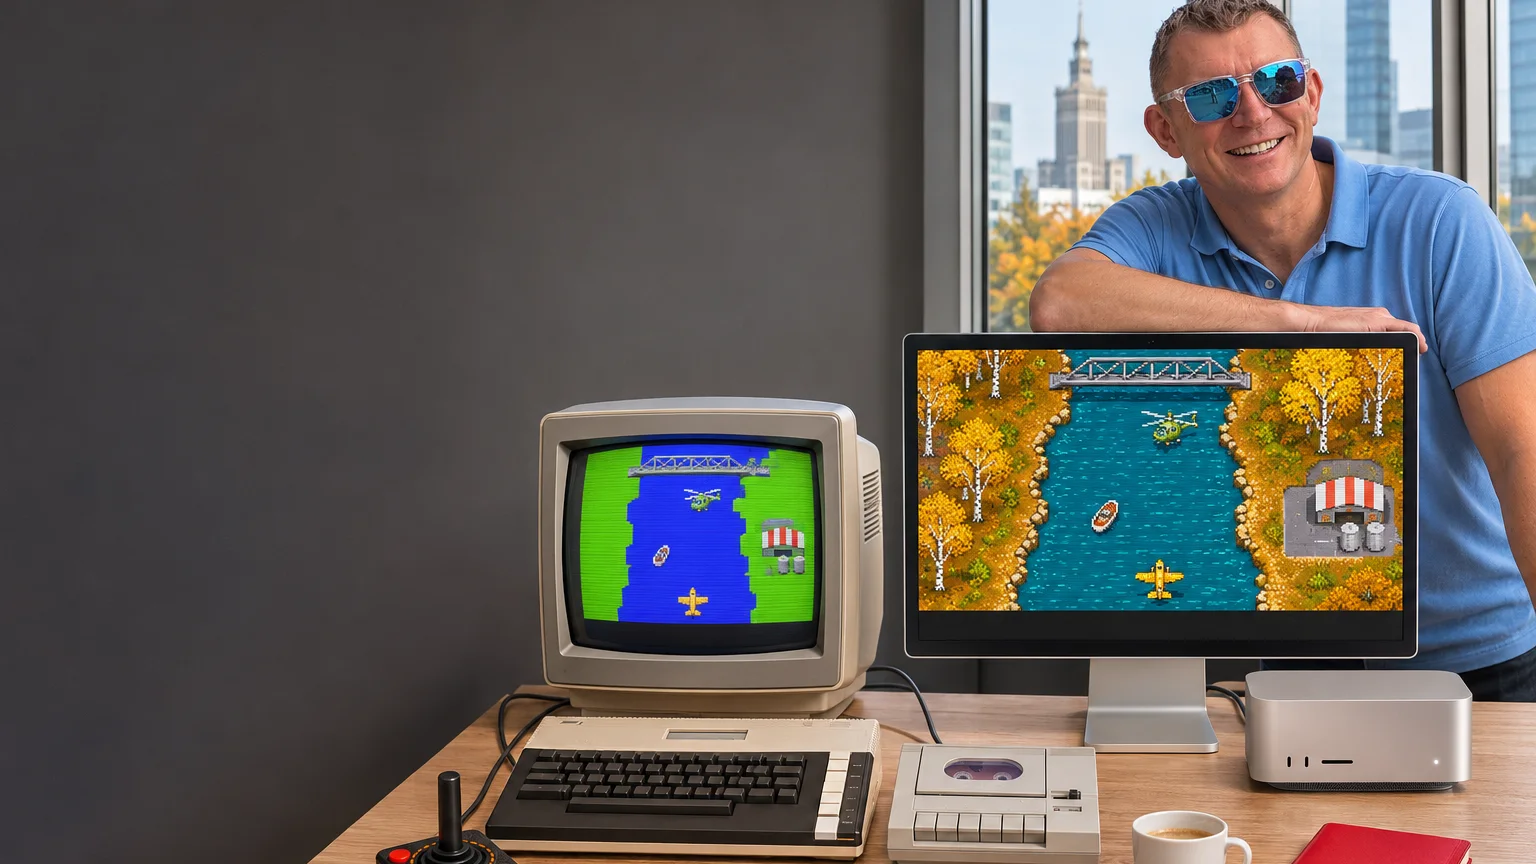
Kiedy w moim domu pojawiło się Atari 800 XL, spędziłem długie godziny, lecąc nad rzeką w River Raid. Ta gra miała jeszcze jedną zaletę, którą doceni każdy, kto miał Atari z magnetofonem kasetowym: wczytywała się szybko. Inne programy ładowały się długie minuty przy akompaniamencie pisku z telewizora, a jeden błąd odczytu oznaczał start od początku. Kto pamięta kręcenie śrubokrętem przy głowicy magnetofonu, wie, o czym piszę.
Krótkie wczytywanie wynikało z rozmiaru gry. Carol Shaw napisała River Raid dla Activision w 1982 roku na konsolę Atari 2600 i zmieściła całą grę w 4 KB. Wersję na komputery Atari, wydaną we wrześniu 1983 roku, w dużej części napisała od nowa i zmieściła w 8 KB. W oryginale rzeka nie była zapisana w pamięci - powstawała na bieżąco z generatora liczb pseudolosowych, bo mapa by się nie zmieściła.
Na potrzeby tego tekstu dałem modelowi językowemu działającemu lokalnie, bez połączenia z internetem, specyfikację gry w duchu tamtych strzelanek. Nazwałem ją „Rzeka Wspomnień”: samolot leci w górę rzeki, strzela do statków i helikopterów, tankuje paliwo i niszczy mosty. Uruchomiłem go na dwóch maszynach - na moim MacBooku Pro i na Lenovo ThinkStation PGX, na którym w SNOK działają modele do zadań ciągłych. Model, który pisał kod, waży 18 GB, czyli ponad dwa miliony razy więcej niż River Raid na Atari.
Gry, które kiedyś pisano w asemblerze, licząc każdy bajt, model lokalny szkicuje dziś w kilka minut, choć do gotowej gry, jak pokazał test, potrzebuje projektu i recenzji od mocniejszego modelu. Ciekawsze od samej gry jest jednak pytanie, jaki komputer kupić, żeby uruchamiać takie modele u siebie, i czy wystarczy Mac, czy potrzebny jest serwer z GPU. Poniżej moja odpowiedź, oparta na specyfikacjach producentów, cenach z apple.com/pl i lenovo.com, naszych pomiarach i tym, jak używamy lokalnych modeli w SNOK.
Najpierw pamięć, potem przepustowość, na końcu nazwa układu
Impulsem do tego tekstu był artykuł „Best Local LLMs for Mac in 2026”, który autor podpisujący się Code&future opublikował 28 października w serwisie „Python in Plain English” na Medium. Autor przyznaje, że po premierze M6 otworzył konfigurator Apple, zanim doczytał specyfikację. Dopiero potem zauważył, że Mac mini z M6 mieści najwyżej 32 GB pamięci, a ten sam komputer ze starszym M5 Pro - 64 GB.
To najważniejsza lekcja przy zakupie sprzętu do modeli lokalnych. Model językowy musi w całości zmieścić się w pamięci, a w komputerach Mac z układami Apple procesor i karta graficzna korzystają z jednej, wspólnej puli pamięci zunifikowanej. Jeżeli model się nie mieści, nie uruchomi się wcale albo będzie doczytywany z dysku tak wolno, że praca z nim straci sens. Jeżeli się mieści, o prędkości decyduje przepustowość pamięci, bo przy generowaniu każdego tokenu układ musi odczytać wagi modelu.
Z tego wynika prosty wzór, którego używam przed każdą rozmową o sprzęcie: przepustowość pamięci podzielona przez wielkość modelu daje teoretyczny sufit liczby tokenów na sekundę. Model gęsty Qwen3.8-27B w czterobitowej kwantyzacji zajmuje około 15,6 GB. Na układzie o przepustowości 614 GB/s sufit wynosi więc około 39 tokenów na sekundę, na układzie o przepustowości 153 GB/s - niecałe 10.
Artykuł wymaga jednej aktualizacji. Autor pisze, że jedynym komputerem z M6 jest Mac mini. Dzień przed publikacją, 27 października, Apple zaprezentował także iMaca i 14-calowego MacBooka Pro z M6. Wniosek się nie zmienia: we wszystkich trzech M6 kończy się na 32 GB.
Dlaczego model zajmuje 5 GB albo 470 GB
Wielkość modelu w pamięci zależy od trzech rzeczy: liczby parametrów, precyzji, z jaką zapisano każdy z nich, i długości kontekstu, który model ma obsłużyć.
Parametry. Model to miliardy liczb, czyli wag ustalonych podczas trenowania. Qwen3.5-9B ma 9,65 mld parametrów, Qwen3.8-27B - 27,8 mld, a Qwen3-235B-A22B - 235 mld. Mniejsze modele z tej samej rodziny są osobnymi sieciami, często uczonymi z pomocą większych (destylacja). Mają mniej wiedzy i słabiej radzą sobie z wieloetapowym rozumowaniem, za to piszą szybciej i mieszczą się w laptopie.
Precyzja i kwantyzacja. Producenci publikują wagi zwykle w formacie BF16, czyli 2 bajty na parametr. Qwen3.8-27B zajmuje wtedy około 56 GB, a Qwen3-235B-A22B - około 470 GB. Kwantyzacja zaokrągla wagi do mniejszej liczby bitów. Ten sam model 27B w 8 bitach zajmuje około 30 GB, a w 4 bitach około 16 GB - format dokłada narzut, więc w praktyce wychodzi około 4,5 bitu na parametr. Dlatego na Hugging Face i w katalogu Ollamy ten sam model występuje w kilku wersjach, a oznaczenia Q8_0, Q4_K_M, FP8, MXFP4 czy „MLX 4-bit” mówią właśnie o precyzji zapisu.
Za mniejszy rozmiar płacimy jakością. Stosujemy praktyczną regułę: 8 bitów trudno odróżnić od oryginału, 4 bity to rozsądny kompromis dla większości zastosowań, a poniżej 4 bitów model częściej myli się w kodzie, liczbach i dłuższym rozumowaniu. Jakości w tym teście nie mierzyłem. Model Qwen3-235B-A22B uruchamialiśmy w naszym laboratorium w 3 bitach - zajmował około 104 GB i mieścił się w jednym PGX.
Modele MoE. Model typu mixture of experts składa się z wielu wyspecjalizowanych bloków i przy każdym tokenie uruchamia tylko część z nich. Qwen3.6-35B-A3B ma 36 mld parametrów, ale aktywuje około 3 mld, co zapisano w nazwie jako A3B. W pamięci musi zmieścić się cały, ale przy każdym tokenie czyta tylko aktywną część, dlatego pisze z prędkością małego modelu. Dla komputerów z 24-32 GB to dziś najlepszy wybór.
Kontekst. Model zajmuje w pamięci więcej, niż waży jego plik. Dla całego tekstu wejściowego przechowuje wyniki pośrednich obliczeń (tzw. KV cache), a ta pamięć rośnie z długością kontekstu. Model qwen3-coder 30B, którego plik ma 18 GB, zajmował w Ollamie na PGX 22 GB przy kontekście 65 536 tokenów, a na moim MacBooku 33 GB przy kontekście 262 144 tokenów. Analiza długiej dokumentacji wymaga więc zapasu pamięci ponad samą wielkość modelu.
Dwie fazy wnioskowania. Wnioskowanie, czyli praca modelu nad odpowiedzią, ma dwie fazy. Najpierw model czyta polecenie i dokumenty, przetwarzając wiele tokenów równolegle - tu liczy się moc obliczeniowa układu. W moim teście Mac przeczytał 4 282 tokeny własnego kodu w nieco ponad 3 sekundy, czyli z prędkością około 1 300 tokenów na sekundę. Potem model pisze odpowiedź token po tokenie i przy każdym czyta wagi z pamięci - tu decyduje przepustowość. Ten sam Mac pisał z prędkością 48,8 tokena na sekundę. Kto analizuje długie dokumenty, powinien patrzeć także na moc obliczeniową, kto głównie generuje tekst albo kod - przede wszystkim na przepustowość.
Cztery klasy układów M w jednym rachunku
Apple oferuje dziś komputery z układami w czterech klasach. Różnią się liczbą rdzeni, ale dla modeli lokalnych najważniejsze są dwie liczby: ile pamięci można dokupić i jak szybko układ ją czyta.
| Układ | Pamięć maks. | Przepustowość | Sufit dla modelu 27B (4 bity) |
|---|---|---|---|
| Apple M5 | 32 GB | 153 GB/s | ok. 10 tok/s |
| Apple M6 | 32 GB | 170 GB/s | ok. 11 tok/s |
| Apple M5 Pro | 64 GB | 307 GB/s | ok. 20 tok/s |
| Apple M5 Max | 128 GB | 614 GB/s | ok. 39 tok/s |
| Apple M5 Ultra | 512 GB | 1,2 TB/s | ok. 77 tok/s |
| NVIDIA GB10 (Lenovo PGX) | 128 GB | 273 GB/s | ok. 18 tok/s |
Wersja M5 Max z 32-rdzeniowym GPU ma 460 GB/s; w tabeli podaję wariant z 40 rdzeniami. Wartości przepustowości pochodzą ze specyfikacji Apple, sufit tokenów policzyłem sam.
Sufit to granica fizyczna. W naszym laboratorium gęsty model 70B na układzie GB10 osiągał około 3 tokenów na sekundę przy suficie 6,9, czyli 43 procent. Przy modelach MoE wzór trzeba liczyć od wielkości aktywnej części, a wtedy sufit wychodzi tak wysoko, że o prędkości decyduje co innego - pokazał to test opisany niżej. Wzór służy do porównywania maszyn między sobą.
Który Mac do czego - od 16 do 512 GB
16 GB - asystent osobisty. Mac mini z M6 i 16 GB pamięci (6 999 zł z dyskiem 1 TB). Wygodnie zmieszczą się tu modele 7-9B, na przykład Qwen3.5-9B, który w czterech bitach zajmuje około 5,4 GB. Wystarczą do streszczania dokumentów, poprawiania tekstów i prostych skryptów. System i przeglądarka też potrzebują swojej części pamięci.
24-32 GB - pierwszy poważny poziom. Mac mini z M6 i 24 albo 32 GB (7 999 albo 8 999 zł) albo 14-calowy MacBook Pro z M6 i tą samą pamięcią (11 499 albo 12 499 zł). Na 24 GB wygodnie zmieści się Qwen3.8-27B, a na 32 GB także Qwen3.6-35B-A3B i Gemma 4 31B. Przy przepustowości 170 GB/s sufit dla gęstego modelu 27B to jednak około 11 tokenów na sekundę, a w praktyce mniej, więc wybierałbym modele MoE.
64 GB - pierwsza maszyna dla zespołu. Mac mini z M5 Pro i 64 GB (14 999 zł) albo 14-calowy MacBook Pro z M5 Pro i 64 GB (18 999 zł). Model klasy 70B w czterech bitach zajmuje około 39 GB, więc formalnie się zmieści, ale przy 307 GB/s sufit to niecałe 8 tokenów na sekundę. Lepiej wykorzystać tę pamięć na model 27B działający ponad dwa razy szybciej i drugi model obok, na przykład do wyszukiwania w dokumentach.
128 GB - maszyna do codziennej pracy. Mac Studio z M5 Max i 128 GB (26 999 zł) albo 14-calowy MacBook Pro z M5 Max i 128 GB (34 499 zł - z tym układem Apple sprzedaje MacBooka Pro tylko z dyskiem co najmniej 2 TB). Na takim komputerze testuję modele. Mieszczą się tu modele MoE do około 120 miliardów parametrów, w tym gpt-oss-120b, który w naszych testach zajmował około 63 GB. To ta sama pojemność co w Lenovo ThinkStation PGX, ale w wersji z 40-rdzeniowym GPU przy 614 GB/s zamiast 273 GB/s.
256-512 GB - laboratorium w jednej obudowie. Mac Studio z M5 Ultra i 256 GB pamięci kosztuje 47 999 zł. Wersję z 512 GB Apple sprzedaje tylko z mocniejszym wariantem układu (36-rdzeniowe CPU, 80-rdzeniowe GPU). Z dyskiem 1 TB kosztuje 111 999 zł. Przy 256 GB mieszczą się modele 235B. Model 405B w czterech bitach zajmuje około 228 GB, więc z rozsądnym zapasem uruchomicie go dopiero na 512 GB. Dlaczego rozważałem taką maszynę jako stację do dowodów koncepcji dla SNOK, opisałem we wrześniu w tekście o Mac Studio 512 GB kontra DGX Spark.
Ceny podaję według konfiguratora apple.com/pl z 7 listopada 2026 roku, zawsze dla wskazanej pamięci i dysku 1 TB, z wyjątkiem MacBooka Pro z M5 Max. W tym samym wariancie układu (36/80) przejście z 256 GB (54 499 zł) na 512 GB kosztuje 57 500 zł, czyli więcej niż dwa Mac Studio z M5 Ultra w konfiguracji bazowej z 96 GB (po 27 999 zł).
Jeden, dwa i cztery Lenovo ThinkStation PGX
Lenovo ThinkStation PGX to stacja z superchipem NVIDIA GB10, 128 GB pamięci zunifikowanej o przepustowości 273 GB/s i pełnym oprogramowaniem NVIDII, czyli tym samym, na którym działają serwery NVIDII w centrach danych. W sierpniu testowaliśmy ją w naszym labie, a dziś w SNOK pracują dwa takie urządzenia. W polskim sklepie Lenovo PGX nie ma publicznej ceny. W listopadzie 2026 roku kosztuje w Polsce około 28 000 zł brutto, czyli mniej więcej tyle, co Mac Studio z M5 Max i 128 GB.
Jeden PGX to pojemność MacBooka Pro z M5 Max przy przepustowości ponad dwukrotnie mniejszej. Przewaga leży gdzie indziej: CUDA, vLLM i SGLang, douczanie modeli i obsługa wielu użytkowników naraz. To, co zbudujecie na PGX, przeniesiecie na serwer w centrum danych bez przepisywania warstwy uruchomieniowej.
Dwa PGX połączone wbudowanymi kartami ConnectX-7 (200 Gb/s) dają 256 GB. Według NVIDII taka para obsługuje modele do 405 miliardów parametrów.
Cztery PGX to 512 GB i według NVIDII modele do 700 miliardów parametrów. Dokumentacja NVIDIA Sync zaktualizowana 30 października mówi wprost, że przy czterech urządzeniach potrzebny jest przełącznik sieciowy; konfiguracja z ośmioma jest zapowiedziana, ale bez terminu.

Łącze 200 Gb/s to 25 GB/s, czyli około jedenastu razy mniej niż przepustowość pamięci wewnątrz jednego PGX. Model rozłożony na kilka urządzeń płaci więc za każdą wymianę danych między nimi. Mac Studio z M5 Ultra trzyma 512 GB w jednej puli o przepustowości 1,2 TB/s. Apple również pozwala łączyć komputery Mac Studio przez Thunderbolt 5, a cztery spięte maszyny według Apple prowadzą wnioskowanie do trzech razy szybciej niż jedna. Tej deklaracji jeszcze nie sprawdzaliśmy.
Mój podział jest więc prosty. Mac wygrywa, gdy liczy się pojemność pamięci w jednej obudowie i przepustowość przy modelach gęstych. PGX wygrywa, gdy model ma trafić na produkcję w środowisku NVIDII, gdy douczamy modele i gdy z jednej maszyny korzysta wielu użytkowników. W moim teście okazał się też szybszy przy modelu MoE.
Test: Rzeka Wspomnień na MacBooku i na PGX
Model uruchomiłem na obu maszynach w identycznej postaci: qwen3-coder 30B w kwantyzacji Q4_K_M, czyli model MoE wyspecjalizowany w kodzie, z około 3 mld aktywnych parametrów. Na obu komputerach był to ten sam plik wag o wielkości 18 GB, uruchomiony w Ollamie, z tymi samymi ustawieniami (temperatura 0,2, stałe ziarno losowania, okno kontekstu 65 536 tokenów) i bez dostępu do internetu.
Zadanie. Model dostał specyfikację gry „Rzeka Wspomnień”: mechanika strzelanki rzecznej z lat 80. (paliwo, mosty, statki, helikoptery, odrzutowce, wyspy), ale własna grafika w jesiennej palecie, ekran wczytywania jak z kasety, ekran tytułowy, pauza, ekran końca gry, dźwięk i sterowanie dotykowe. Do specyfikacji dołączyłem 12 kryteriów akceptacji, które sprawdzał automatyczny test w przeglądarce. Najtrudniejsze z nich wymagało, żeby prosty autopilot przeleciał co najmniej trzy mosty.
Prędkość przy krótkiej odpowiedzi. Przy poleceniu napisania mniejszej gry, około 4 tys. tokenów odpowiedzi, MacBook Pro z M4 Max pisał 70,5 i 71,2 tokena na sekundę, a PGX 77,7 i 78,4.
Prędkość przy długiej odpowiedzi. Pełna specyfikacja to ponad 10 tys. tokenów kodu. Tu MacBook pisał w trzech przebiegach od 30,5 do 40,8 tokena na sekundę, a PGX z wolnym GPU 62,5 tokena na sekundę w jednym przebiegu. Gdy na tym samym PGX równolegle pracowały nasze testy bezpieczeństwa agentów, prędkość spadała do 28-36 tokenów na sekundę.
Jakość. Pierwsza wersja z MacBooka przeszła 2 z 12 testów, pierwsza z PGX - żadnego. Raport z testów wracał do modelu jako kolejne polecenie, a od trzeciej wersji dokładałem recenzję kodu z przyczynami błędów. Czwarta wersja z MacBooka przechodziła 6 testów, trzecia wersja z PGX - 7. Model popełniał błędy, które doświadczony programista wyłapuje od razu: na obu maszynach liczył czas zegarem ściennym zamiast czasem symulacji, a na MacBooku brał resztę z dzielenia liczby losowej z przedziału od 0 do 1, przez co rzeka prawie się nie zmieniała, a wyspy nie powstawały. Grę, która przechodzi wszystkie 12 testów, napisałem najpierw od nowa z Claude Code, modelem działającym w chmurze, według tej samej specyfikacji, a potem jej drugą wersję w stylu automatu do gier, z jesiennym lasem brzozowym, stalowym mostem i stacją paliw pod pasiastym daszkiem. Autopilot przelatuje w niej osiem mostów. Na koniec odwróciłem role. Claude Code podzielił grę na osiem modułów, rozpisał algorytmy w punktach, opisał samolot, statki i stację paliw jako listy prostokątów ze współrzędnymi, napisał testy i po każdej rundzie wskazywał przyczyny błędów. Cały kod napisał lokalny model na MacBooku Pro z M4 Max i 128 GB pamięci, bez internetu i bez żadnej ręcznej poprawki. Po 28 wywołaniach i około 57 minutach generowania ta wersja przeszła 12 z 12 testów, a autopilot przeleciał w niej pięć mostów. To ją uruchamia plakat poniżej.
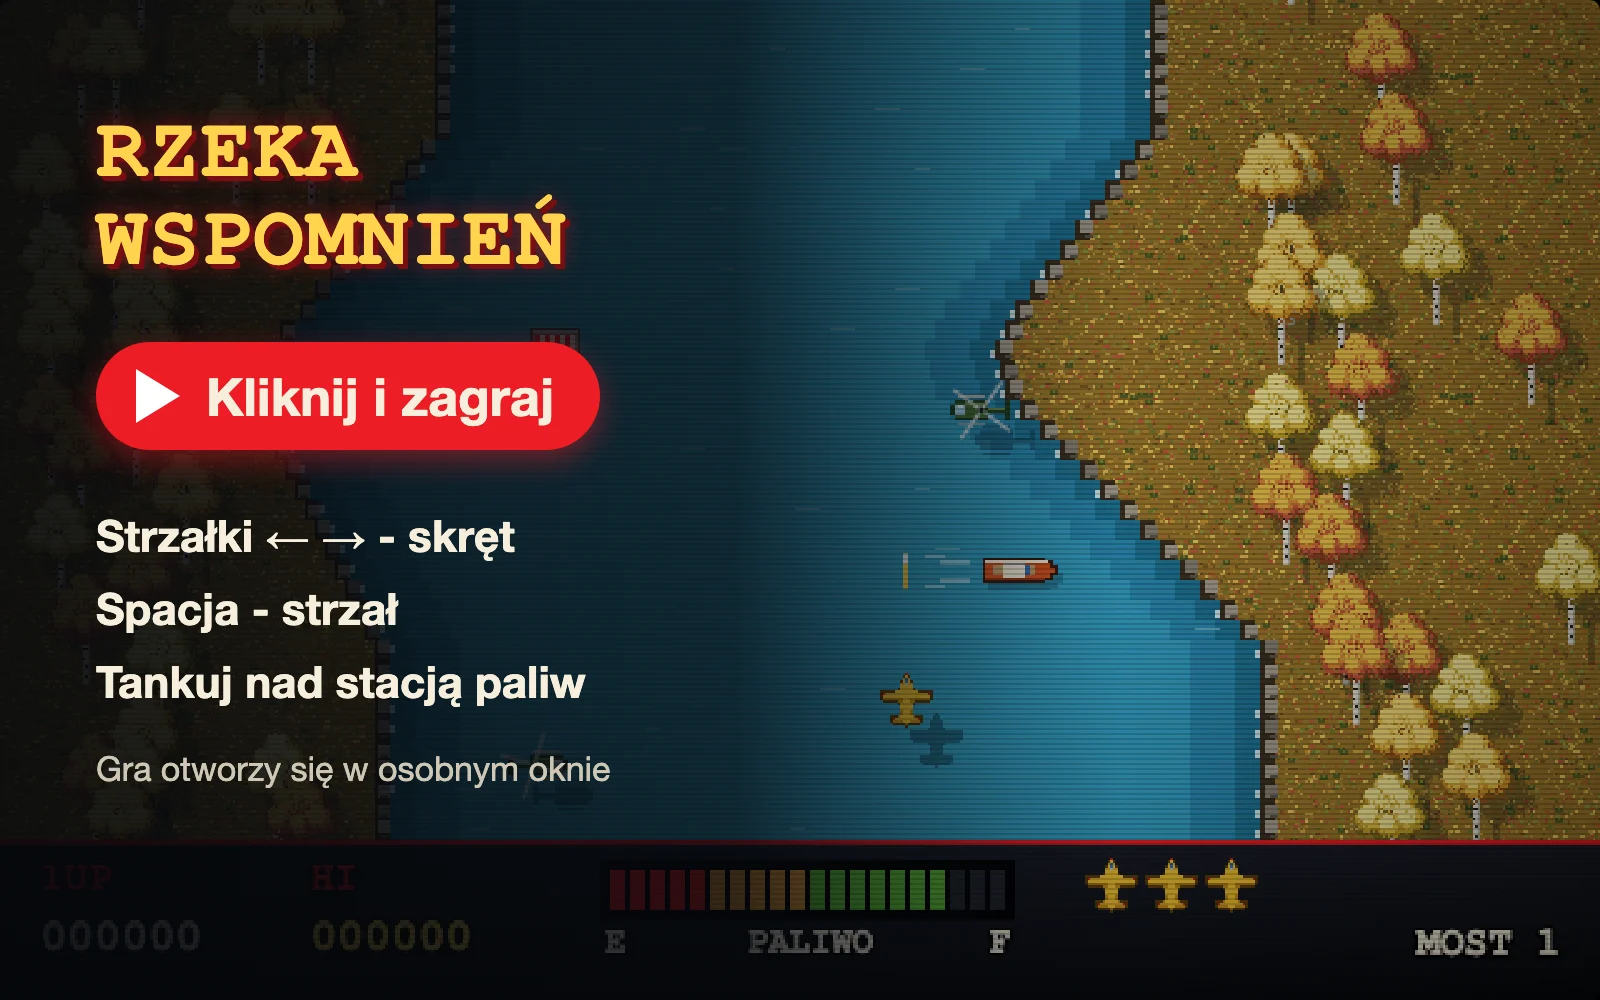
Gra otwiera się w osobnym oknie i działa także na telefonie, najlepiej trzymanym poziomo. Wersję napisaną z Claude Code znajdziecie na osobnej stronie.
Z testu wynikają trzy wnioski. Po pierwsze, przy modelu MoE PGX z połową przepustowości MacBooka był szybszy, a przy długiej odpowiedzi przewaga była większa. Model MoE czyta przy każdym tokenie tylko około 2 GB wag, więc najbardziej prawdopodobnym wyjaśnieniem jest moc obliczeniowa i oprogramowanie - CUDA na PGX, Metal na komputerze Mac. W laptopie pod długim obciążeniem może dochodzić ograniczenie termiczne, a na wolnym PGX długą odpowiedź zmierzyłem tylko raz. To wynik jednego modelu i kilku przebiegów, nie reguła. Po drugie, maszyna współdzielona pisze tak szybko, jak pozwalają jej inne zadania, dlatego konkretną prędkość podaję klientowi dopiero po pomiarze na docelowym modelu i przy docelowym obciążeniu. Po trzecie, model lokalny 30B dobrze sprawdza się przy szkicu, kodzie pomocniczym i poprawkach według listy błędów, a gotowy produkt dostarczył dopiero pod nadzorem modelu w chmurze, który przygotował mu projekt, testy i recenzje błędów. Taką rolę wyznaczamy mu w SNOK, a specyfikację, kod, polecenia i wyniki pomiarów trzymamy w repozytorium wiedzy, żeby za pół roku powtórzyć test na nowym sprzęcie.
Jak używamy lokalnych modeli w SNOK
Lokalne modele pracują u nas na dwóch poziomach.
Na moim MacBooku testuję modele. Sprawdzam nowe wersje, porównuję je na tych samych poleceniach, tak jak w teście opisanym wyżej, i wybieram te, które warto przenieść na serwer.
Modele do zadań ciągłych działają na dwóch Lenovo ThinkStation PGX. Pomagają zespołowi w kodowaniu, w analizie przetargów i w testach bezpieczeństwa agentów AI. Przy przetargach model zestawia wymagania z dokumentacji z naszymi kompetencjami. Same dokumenty są jawne, ale nasza ocena szans i decyzja o złożeniu oferty to informacje, których nie chcemy wysyłać do zewnętrznego dostawcy. W testach bezpieczeństwa lokalny model sprawdza odporność agentów na manipulację, zanim zaproponujemy je klientowi. Na PGX przygotowaliśmy też, na danych syntetycznych, demo asystenta AI przeznaczonego do pracy wyłącznie na infrastrukturze klienta.
Zgodnie z naszym systemem zarządzania bezpieczeństwem informacji (ISO 27001) dane klienta objęte NDA przetwarzamy w jego środowisku, nie na naszym sprzęcie. Jeżeli model ma pracować na takich danych, uruchamiamy go u klienta - i to jeden z powodów, dla których klienci pytają nas o modele językowe on-premise i asystentów AI na własnych dokumentach.
Który model do czego - moja ściąga
| Dla kogo | Sprzęt | Model |
|---|---|---|
| Zarząd, menedżer | Mac mini M6, 16 GB | Qwen3.5-9B |
| Analityk, konsultant | MacBook Pro M6, 32 GB | Qwen3.6-35B-A3B |
| Programista | Mac mini M5 Pro, 64 GB | qwen3-coder 30B, Qwen3.8-27B |
| Zespół, dział | PGX albo Mac Studio M5 Max | gpt-oss-120b |
| Laboratorium, dowody koncepcji | Mac Studio M5 Ultra albo dwa PGX | Qwen3-235B-A22B |
Zarząd i menedżerowie. Do streszczania dokumentów, poprawiania tekstów i przygotowania notatek wystarczy model 7-9B. Qwen3.5-9B w czterech bitach zajmuje około 5,4 GB i działa na podstawowym komputerze Mac mini z 16 GB. Polecam LM Studio, bo instalacja i wybór modelu nie wymagają pracy w terminalu.
Analitycy i konsultanci. Przy długich dokumentach liczy się zapas pamięci na kontekst. Qwen3.6-35B-A3B w czterech bitach zajmuje około 20 GB i pisze z prędkością małego modelu, więc na komputerze z 32 GB zostaje zapas na dokumenty średniej długości. Przy bardzo długich materiałach wybrałbym 64 GB.
Programiści. Model qwen3-coder 30B sprawdziłem w tym teście: jest szybki i nadaje się do szkiców, testów i poprawek. Do trudniejszych zadań wybrałbym gęsty Qwen3.8-27B, który pisze wolniej, ale przy każdym tokenie korzysta z całej sieci. Każdy z nich osobno zmieści się w 32 GB, ale 64 GB z M5 Pro pozwala trzymać je obok siebie bez walki o pamięć ze środowiskiem programistycznym i przeglądarką.
Zespół albo dział. Gdy z modelu korzysta kilka osób naraz, wybrałbym PGX: vLLM obsługuje wiele zapytań równolegle, a rozwiązanie zbudowane na PGX przeniesiecie na serwer. Model gpt-oss-120b zajmował w naszych testach około 63 GB i pisał na GB10 56-60 tokenów na sekundę. Dla jednej osoby z dużymi wymaganiami lepszy będzie Mac Studio albo MacBook Pro z M5 Max i 128 GB.
Laboratorium i dowody koncepcji. Qwen3-235B-A22B w trzech bitach zajmował u nas około 104 GB i na jednym GB10 pisał około 15,6 tokena na sekundę. W czterech bitach modele 235B wymagają już Mac Studio z M5 Ultra albo dwóch PGX, a modele 405B - 512 GB pamięci.
Jeżeli macie dziś komputer Mac z 16 GB, zacznijcie od Ollamy albo LM Studio i modelu 7-9B na własnych dokumentach. Tydzień takiej pracy daje lepszą podstawę decyzji zakupowej niż jakikolwiek ranking. Jeżeli kupujecie sprzęt, zacznijcie od modelu: policzcie, ile zajmuje w czterech bitach, dodajcie zapas na kontekst, system i drugi model, a dopiero potem wybierzcie klasę układu. Jeżeli chcecie porównać komputer Mac i PGX na własnym przypadku, zanim cokolwiek kupicie, napiszcie do nas.
Źródła
- Code&future, „Best Local LLMs for Mac in 2026: The Ultimate M1 to M6 Guide”, Python in Plain English, 28.10.2026 (dostęp 06.11.2026)
- Apple Newsroom, M5 Pro i M5 Max, 03.03.2026 (dostęp 06.11.2026)
- Apple Newsroom, Mac mini z M6 i M5 Pro, 25.08.2026 (dostęp 06.11.2026)
- Apple Newsroom, Mac Studio z M5 Max i M5 Ultra, 25.08.2026 (dostęp 06.11.2026)
- Apple Newsroom, MacBook Pro 14” z M6 i iMac z M6, 27.10.2026 (dostęp 06.11.2026)
- Apple Store, konfigurator Mac Studio (dostęp 07.11.2026)
- NVIDIA, DGX Spark (dostęp 08.09.2026) i NVIDIA Sync - Cluster Assistant (dostęp 06.11.2026)
- Hugging Face, karty modeli Qwen3.6-35B-A3B, Qwen3.8-27B, Qwen3.5-9B (dostęp 06.11.2026)
- Wikipedia, River Raid (dostęp 07.11.2026)
- Pomiar własny SNOK: MacBook Pro M4 Max 128 GB i Lenovo ThinkStation PGX, Ollama, qwen3-coder 30B Q4_K_M, 06-07.11.2026