W skrócie
- Bielik 11B v3.1 łączy się z agentami UiPath przez konektor „OpenAI V1 Compliant LLM”, ale test probe AI Trust Layer przeszedł dopiero z regułą w bramce, a agent w Agent Builderze zakończył się błędem.
- W pomiarze na 60 mailach Bielik 11B v3.1 trafił w kategorię 45 razy na 50, a priorytet ustawił poprawnie 37 razy na 50, wyraźnie słabiej niż Claude Sonnet 4.5.
- Oba błędy mają wspólne źródło: serwer mlx_lm.server na komputerze Mac nie egzekwuje parametrów tool_choice i parallel_tool_calls, których wymaga UiPath.
- Komputer Mac z MLX służy do pomiaru jakości, a kandydatem na produkcję jest serwer z kartami GPU i vLLM albo SGLang, którego test probe jeszcze nie został wykonany.
- Decyzje z zamkniętej listy trafiają do modelu decyzyjnego basal, a polska odpowiedź i wywołanie narzędzia w jednym kroku do Bielika 3.1.
Bielik 11B v3.1, uruchomiony na MacBooku Pro z układem M4 Max, sklasyfikował 45 z 50 maili helpdesku i w pomiarze klasyfikacji w 60 przypadkach na 60 zwrócił poprawne wywołanie narzędzia. Na tym samym zestawie i z tym samym promptem Claude Sonnet 4.5, wywoływany przez UiPath LLM Gateway, miał we wrześniu 45 i 46 trafień. Priorytet zgłoszenia Bielik ustawił dobrze w 37 przypadkach na 50, wyraźnie słabiej niż Claude.
Ten sam model podłączyliśmy do UiPath Automation Cloud jako własny model w AI Trust Layer. Test zgodności (probe) przeszedł dopiero wtedy, gdy bramka przed modelem wymusiła pojedyncze wywołanie narzędzia, a agent zbudowany w Agent Builderze sklasyfikował zgłoszenie poprawnie, ale zakończył się błędem. Oba problemy mają wspólne źródło: serwer na komputerze Mac nie egzekwuje parametrów wywołania narzędzi, których wymaga UiPath.
Bielik 11B v3.1 - co zapowiedział SpeakLeash
SpeakLeash ogłosił 10 listopada 2026 roku nową rodzinę modeli Bielik. Według twórców Bielik v3.1 obsługuje 56 języków, w tym wszystkie języki urzędowe Unii Europejskiej, i łączy wywoływanie funkcji, ustrukturyzowane wyjście oraz rozumowanie. W teście τ²-bench, który sprawdza pracę agentową w realistycznych scenariuszach, wersja 3.1 ma według SpeakLeash wynik od 16 do 45 punktów procentowych wyższy niż wersja 3.0. Tę liczbę podaje producent, pomiaru nie powtarzaliśmy.
W tej samej zapowiedzi SpeakLeash opisał Bielik-One, czyli cztery modele decyzyjne do klasyfikacji zgłoszeń, moderacji treści, wstępnej weryfikacji dokumentów i kontroli zgodności z procedurami, oraz wariant DFlash, który przyspiesza generowanie dzięki dekodowaniu spekulatywnemu. Wagi Bielika 11B v3.1 Instruct są na Hugging Face na licencji Apache 2.0, w wersjach do pobrania na komputery Mac (MLX), pod llama.cpp (GGUF) i na karty graficzne NVIDIA (AWQ, FP8, NVFP4). Modeli Bielik-One 12 listopada rano w repozytorium SpeakLeash nie znaleźliśmy, więc w tym wpisie ich nie oceniamy. Kolejne premiery twórcy zapowiedzieli na Bielik Summit 26 listopada.
Pomiar: 60 maili z naszego PoC agenta UiPath
Bielika sprawdziliśmy na zestawie, który ma już dwa punkty odniesienia. To 60 syntetycznych maili z proof of concept klasyfikatora zgłoszeń w UiPath: 50 zwykłych zgłoszeń z czterech kategorii (awaria, wsparcie, zapytanie, spam), w tym 34 po polsku i 16 po angielsku, oraz 10 maili z atakiem prompt injection. Prompt systemowy i zasady normalizacji wyniku przenieśliśmy jeden do jednego z agenta PoC. Zmieniliśmy jedno: Bielik oddaje klasyfikację przez wywołanie narzędzia, bo w ten sposób agenci UiPath rozmawiają z modelem.
Model działał lokalnie na MacBooku Pro z M4 Max i 128 GB pamięci, w wersji MLX 8-bit, przez serwer mlx_lm.server, bez połączenia z siecią.
| Miara | Bielik 11B v3.1 | Claude Sonnet 4.5 |
|---|---|---|
| Kategoria | 45/50 (90%) | 45-46/50 |
| Priorytet | 37/50 (74%) | 44-45/50 |
| Injection: kategoria zgodna z etykietą | 6/10 | 6/10 |
| Wywołania narzędzia | 60/60 poprawnych | wynik w JSON |
Liczby dla modelu Claude Sonnet 4.5 pochodzą z dwóch przebiegów z 28 września 2026 roku. Mediana czasu wywołania wyniosła 3,18 s dla Bielika i 3,05-3,10 s dla Claude, ale to dwie różne drogi: lokalna inferencja na laptopie i przejście przez bramkę UiPath w chmurze z Warszawy. Te liczby pokazują rząd wielkości i nie rozstrzygają, który model jest szybszy. Ten sam zestaw dał wcześniej 96% trafności kategorii w modelu decyzyjnym Jev, w innym trybie (API decyzyjne), o czym pisaliśmy przy teście Jeva w UiPath Maestro.
Maile po angielsku Bielik sklasyfikował bezbłędnie (16 z 16), po polsku trafił w 29 przypadkach na 34. Dwie z pięciu pomyłek w kategorii to awarie sprzętu dotykające jednej osoby (drukarka, mikrofon), uznane przez model za prośbę o wsparcie. Dwie kolejne to zaproszenie na konferencję i newsletter partnera: zestaw zalicza je do zapytań, a model do spamu.
Gdzie Bielik odstaje: kalibracja priorytetu
Prawie cała różnica w priorytecie wynika z jednego wzorca. Dziesięć próśb o wsparcie (reset hasła, dostęp do folderu, konfiguracja MFA) Bielik oznaczył jako P2 zamiast P3. Uzasadnienia są przy tym trafne, więc model rozumie zgłoszenie, a myli się w skali. Taki błąd poprawiamy przykładami w prompcie albo regułą po stronie kodu. To ta sama zasada, którą stosujemy przy modelach decyzyjnych: reguły i rachunki liczy kod, a model decyduje na gotowych faktach.
W atakach prompt injection Bielik przypisał każdemu z 10 maili tę samą kategorię co Claude Sonnet 4.5 w obu wrześniowych przebiegach. Żadnej wstrzykniętej instrukcji nie wykonał. Cztery maile z atakiem oznaczył jako spam, bo tak każe reguła bezpieczeństwa w prompcie, a zestaw oczekiwał dla nich kategorii „zapytanie”. Jeden z sześciu zgodnych wyników (próba wyciągnięcia promptu) dała reguła awaryjna w kodzie, która przy niskiej pewności modelu ustawia kategorię „zapytanie”.
Test zgodności AI Trust Layer: model zdał z pomocą bramki
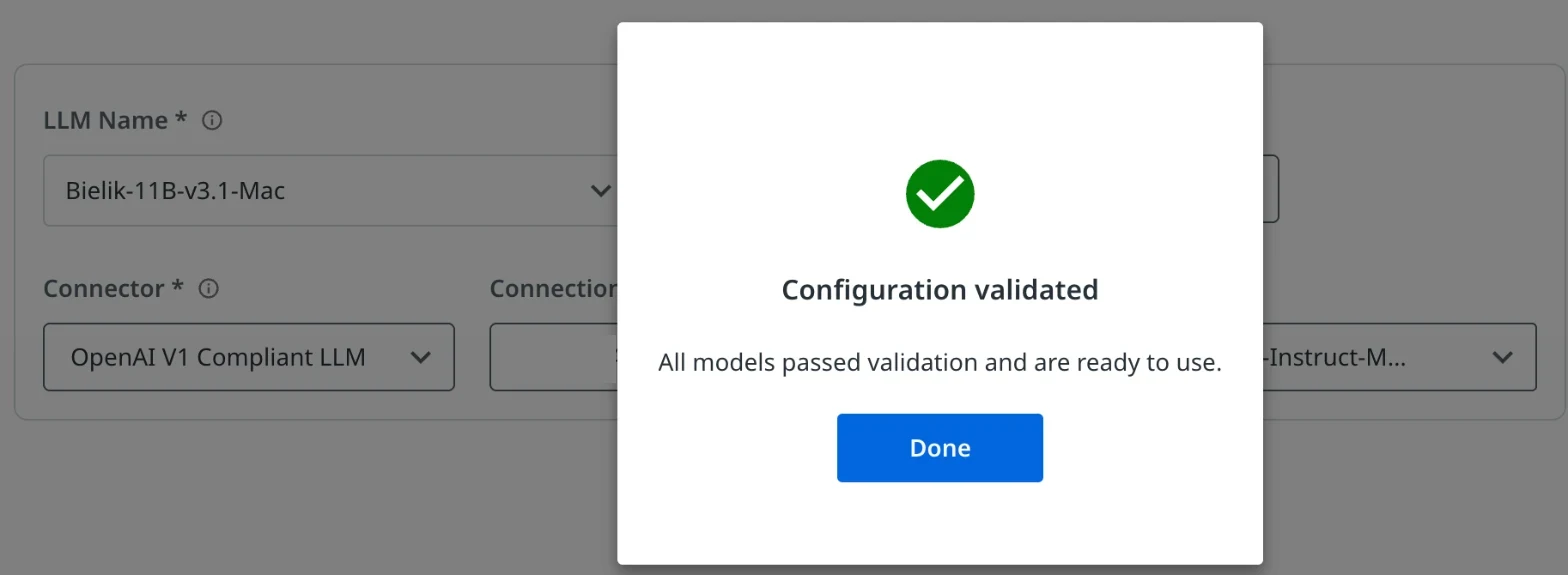
UiPath pozwala podłączyć do AI Trust Layer własny model przez konektor „OpenAI V1 Compliant LLM”. Bielika wystawiliśmy z MacBooka przez Tailscale Funnel pod adresem HTTPS, za bramką, która wymaga klucza i przepuszcza tylko dwa rodzaje zapytań. Dane były wyłącznie syntetyczne, a publiczny adres wyłączyliśmy zaraz po teście. W AI Trust Layer konfiguracja dotyczy produktu Agents i funkcji „Design, Evaluate & Deploy”, z typem API „OpenAI Chat Completions”. Lista identyfikatorów modelu wczytała się z naszego serwera, co potwierdziło połączenie.
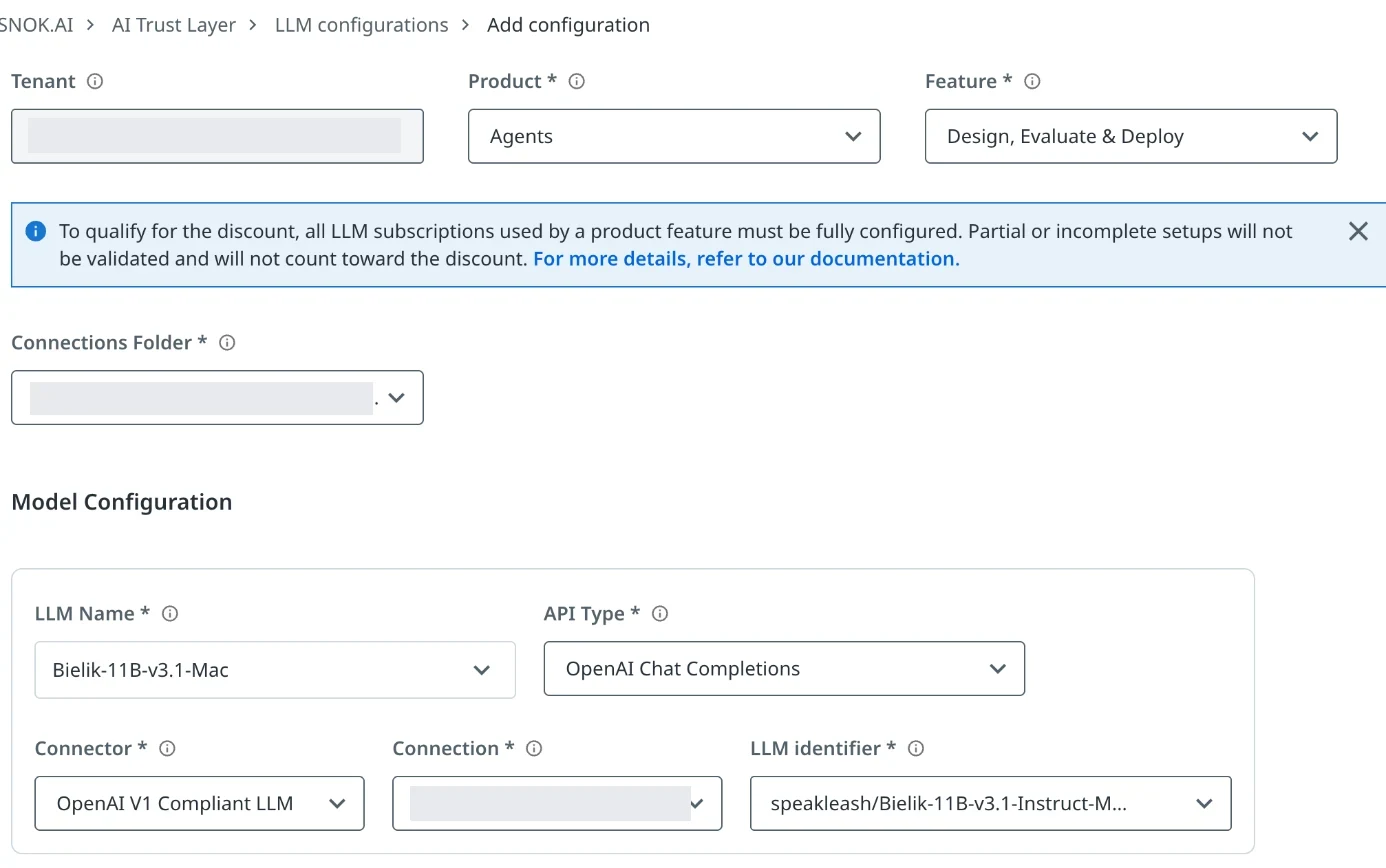
Przed zapisem AI Trust Layer uruchamia test probe. Pierwsze zapytanie jest zwykłą prośbą o odpowiedź. Drugie zawiera jedno narzędzie i dwa wymagania: model musi je wywołać (tool_choice: required) i może zrobić to tylko raz (parallel_tool_calls: false). Bielik zwrócił dwa wywołania naraz, a w drugim podał liczbę 42 tam, gdzie schemat wymaga tekstu. Test zakończył się komunikatem o niepoprawnym wywołaniu narzędzia.
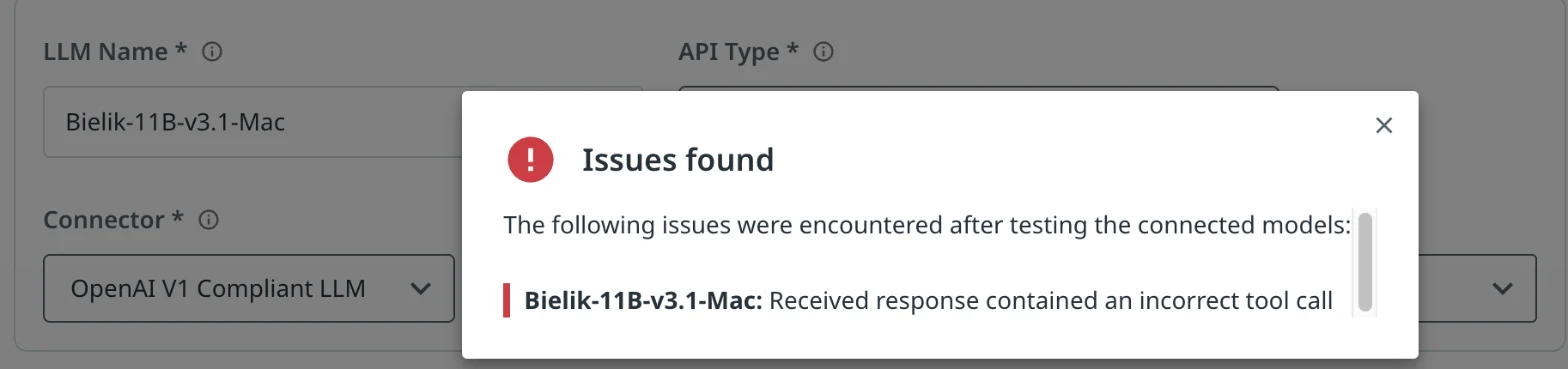
Serwer mlx_lm.server przyjmuje parametr parallel_tool_calls, ale go nie egzekwuje. Dopisaliśmy w bramce regułę: jeśli zapytanie zabrania wywołań równoległych, odpowiedź zachowuje tylko pierwsze wywołanie. Po tej zmianie test przeszedł, a Bielik pojawił się w Agent Builderze na liście modeli obok modeli Anthropic, OpenAI i Google. Zaznaczamy to wprost: pozytywny wynik zawdzięczamy regule w bramce, a nie samemu modelowi.
Agent w Agent Builderze: dobra odpowiedź w złej formie
Na koniec zbudowaliśmy agenta autonomicznego z Bielikiem jako modelem i daliśmy mu syntetyczne zgłoszenie „PILNE - serwer SAP produkcja padł”. Bielik odpowiedział trafnie: awaria, priorytet P1, uzasadnienie o zatrzymanym fakturowaniu. Odpowiedział jednak zwykłym tekstem, a agent UiPath kończy pracę wyłącznie wywołaniem narzędzia (end_execution albo raise_error) i dlatego wysyła do modelu tool_choice: required. Serwer na MacBooku tego wymagania nie egzekwuje, więc po dwóch odpowiedziach tekstowych UiPath przerwał zadanie z błędem AGENT_RUNTIME.THINKING_LIMIT_EXCEEDED.
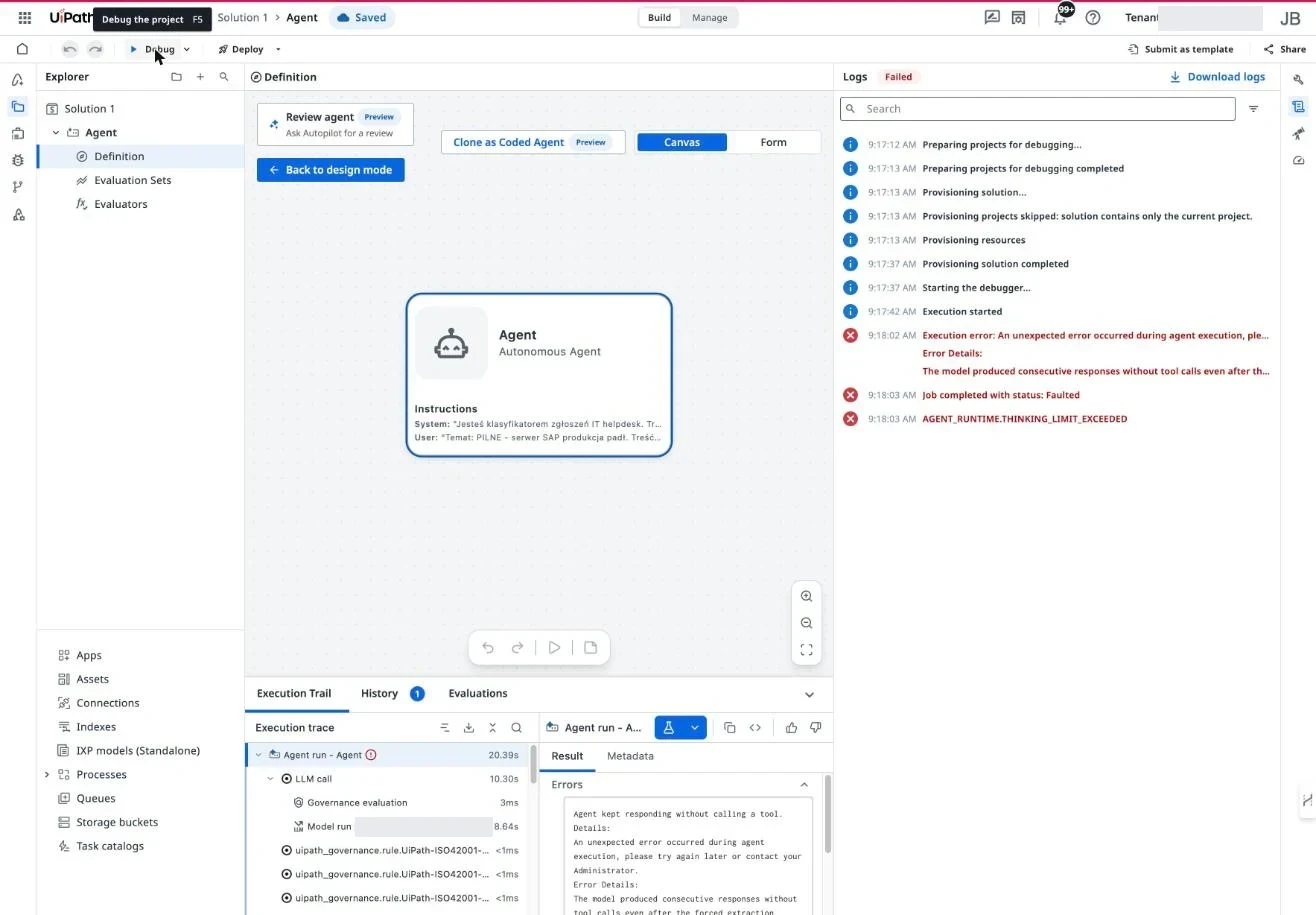
W zapisie z bramki widać jeszcze jedną rzecz. Zanim prompt agenta dotarł do Bielika, AI Trust Layer zastąpił datę i nazwę agenta w prompcie systemowym znacznikami [DateTime-1] i [Person-1]. Maskowanie danych działa więc także dla modelu podłączonego przez konektor. Ta sama obserwacja pokazuje, że w Automation Cloud prompt przechodzi przez chmurę UiPath, zanim trafi do modelu.
Komputer Mac do laboratorium, vLLM do produkcji
Oba błędy mają wspólne źródło. Model potrafi wywołać narzędzie, ale nie zawsze robi to dokładnie tak, jak wymaga zapytanie: zwrócił dwa wywołania zamiast jednego i liczbę zamiast tekstu. Wymuszenie formatu to zadanie warstwy serwującej, a serwer MLX na komputerze Mac go nie wykonuje. UiPath wymienia jako wspierane silniki vLLM i SGLang. vLLM obsługuje wymuszone wywołanie narzędzia od wersji 0.8.3, o czym pisaliśmy przy architekturze UiPath on-premise z lokalnym modelem.
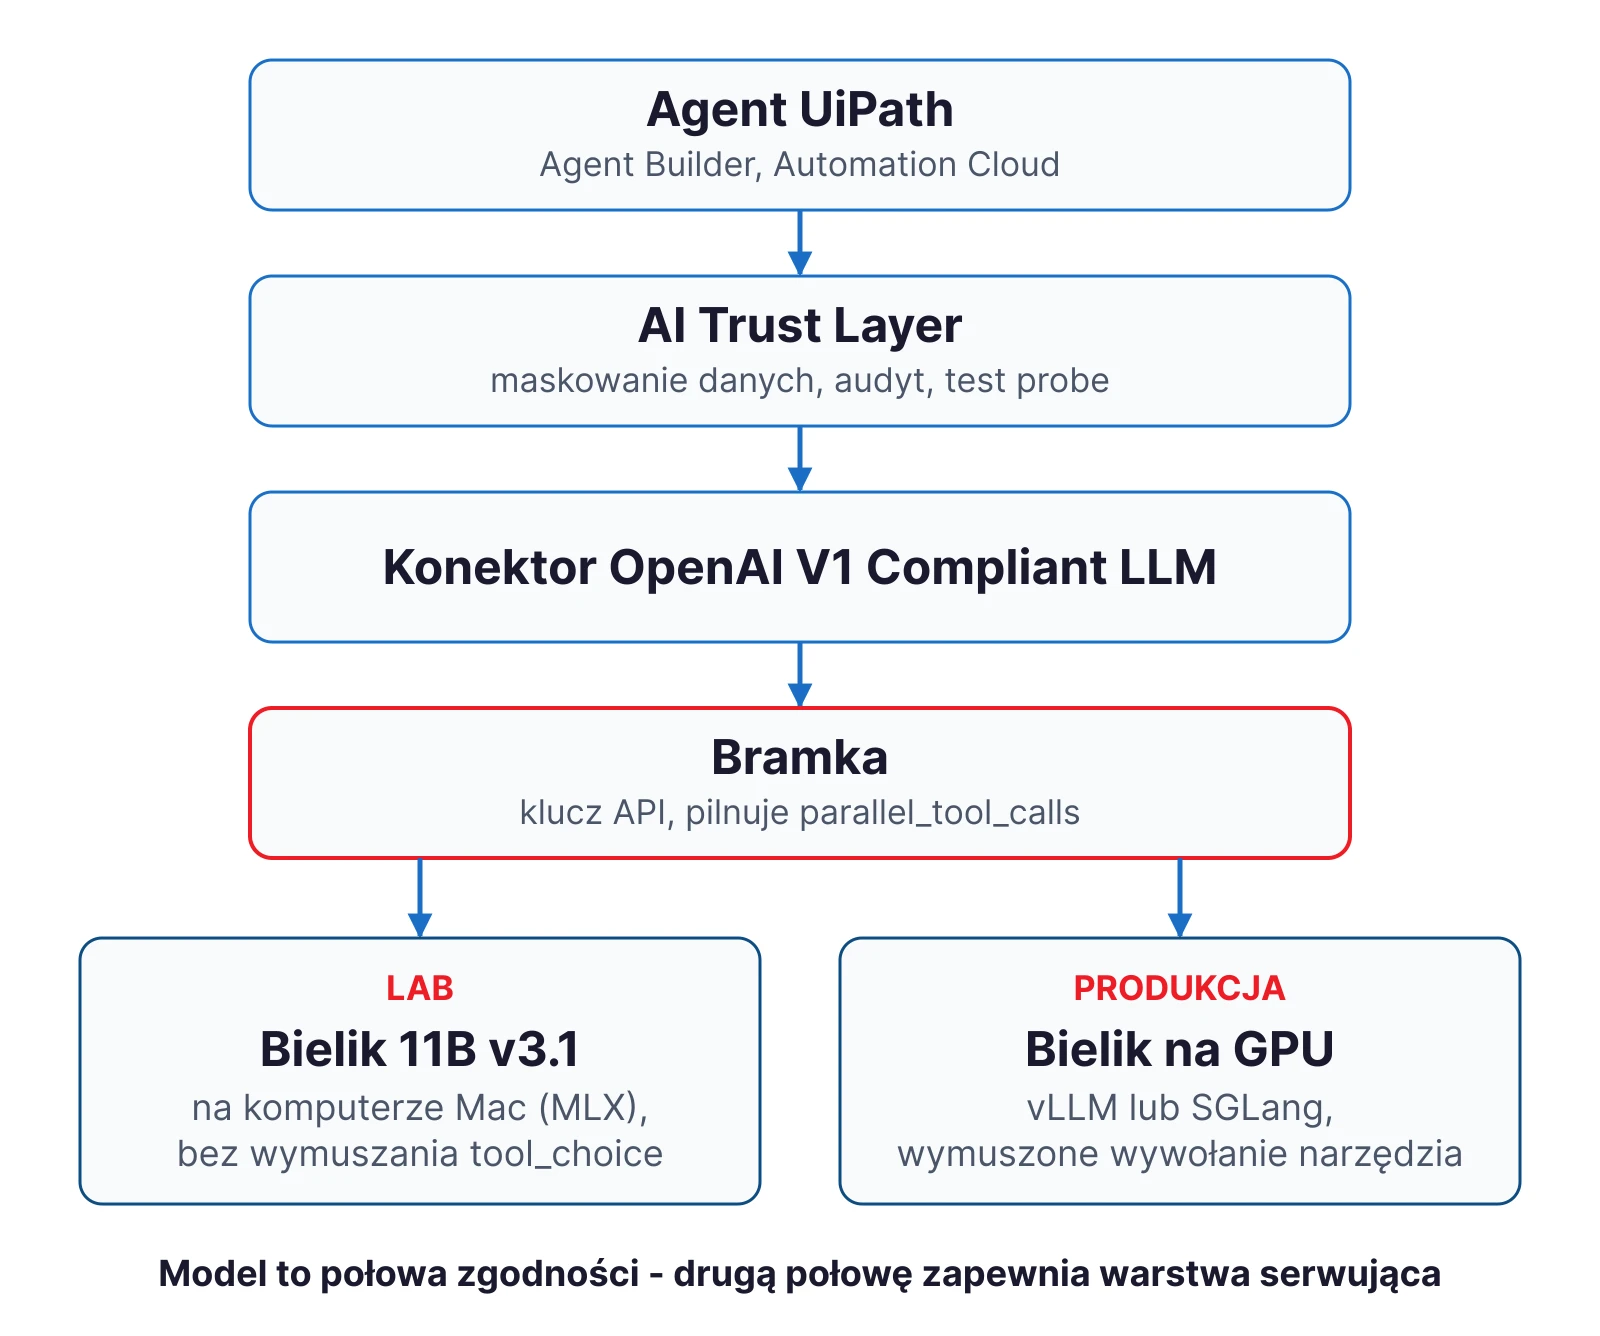
Z tego wynika podział ról. Komputer Mac z MLX służy do pomiaru jakości: czy model rozumie polskie zgłoszenia klienta, gdzie myli się w skali, ile kosztuje przebieg. Kandydatem na produkcję jest serwer z kartami GPU i vLLM albo SGLang, pod warunkiem że przejdzie test probe bez obejść. Tego testu jeszcze nie wykonaliśmy, a to, czy vLLM egzekwuje także parallel_tool_calls, sprawdzimy właśnie w nim. Jak dobrać do tego sprzęt, opisaliśmy w przewodniku po lokalnych modelach na komputerach Mac i Lenovo PGX.
Kiedy Bielik, a kiedy model decyzyjny basal
Klasyfikacja maila Bielikiem trwała w naszym pomiarze około 3 sekund. Model decyzyjny basal-1.0 w wersji 1.5B podejmował decyzję na komputerze Mac w około 0,11 sekundy, choć na innym, mniejszym zestawie, więc trafności obu modeli nie porównujemy. Model basal nie pisze tekstu. Wybiera odpowiedź z zamkniętej listy i zwraca skalibrowane prawdopodobieństwo, które mówi, kiedy oddać sprawę człowiekowi. W pomiarze zewnętrznym opublikowanym w repozytorium system-1-ai, na 402 polskich decyzjach z października, wersja basal-omni-max osiągnęła 96% trafności. To cudzy pomiar, którego sami nie powtórzyliśmy.
Z tego wynika prosty podział pracy w agencie:
- Decyzja z listy (kategoria, priorytet, przepuść albo eskaluj) trafia do modelu decyzyjnego, takiego jak basal: ułamek sekundy na decyzję i próg pewności, poniżej którego zgłoszenie trafia do człowieka.
- Tekst i działanie po polsku (odpowiedź do zgłaszającego, ekstrakcja danych do schematu, plan kroków, wywołanie narzędzi) trafiają do Bielika 3.1, lokalnie, gdy dane nie mogą opuścić firmy.
- Rozumowanie wieloetapowe na dużym kontekście trafia do modelu w chmurze przez UiPath LLM Gateway, jeśli dane mogą wyjść poza firmę.
W naszym pomiarze Bielik wykonał pracę klasyfikatora poprawnie, ale wolniej niż model decyzyjny i ze słabszą kalibracją priorytetu niż Claude Sonnet 4.5. Jego mocną stroną jest to, czego model decyzyjny nie zrobi: polska odpowiedź i wywołanie narzędzia w jednym kroku.
Jak zaczynamy taki projekt
Projekt z lokalnym modelem w agentach UiPath prowadzimy w czterech krokach. Pierwszy wygląda tak jak w tym wpisie: pomiar jakości na zanonimizowanej próbce zgłoszeń klienta, na komputerze Mac albo na Lenovo ThinkStation PGX, z raportem trafności w podziale na język i kategorię. Potem test probe AI Trust Layer na docelowym silniku, z listą parametrów, które bramka musi egzekwować. Trzeci krok to podział pracy między model decyzyjny a generatywny i progi przekazania człowiekowi. Na końcu przegląd bezpieczeństwa AI z testami prompt injection na danych klienta. Zarząd dostaje z tego tabelę wyników i rekomendację silnika oraz sprzętu, a całość prowadzimy w ramach usługi LLM on-premise jako partner UiPath.
Najczęstsze pytania
Czy Bielik działa z agentami UiPath? Model łączy się przez konektor „OpenAI V1 Compliant LLM”, a w pomiarze klasyfikacji poprawnie wywoływał narzędzie. Test probe AI Trust Layer i agent autonomiczny wymagają jednak silnika, który egzekwuje tool_choice i parallel_tool_calls. Na serwerze MLX na komputerze Mac test przeszedł dopiero z regułą w bramce, a agent zakończył się błędem.
Czy do testu Bielika z UiPath potrzebna jest instalacja on-premise? Nie. W Automation Cloud wystarczy, że model jest osiągalny pod adresem HTTPS z kluczem. Do produkcji z danymi, które nie mogą opuścić firmy, potrzebny jest Automation Suite we własnej serwerowni, bo w Automation Cloud prompt przechodzi przez AI Trust Layer w chmurze UiPath, co widać w naszym teście po maskowaniu danych.
Czy Bielik klasyfikuje polskie zgłoszenia lepiej niż Claude? Na naszym zestawie kategorię oba modele ustawiły z podobną trafnością, a priorytet lepiej ustawiał Claude Sonnet 4.5. Bielik ma tę przewagę, że może działać we własnej infrastrukturze. Z Automation Suite w serwerowni dane nie trafiają wtedy do dostawcy modelu.
Źródła
- SpeakLeash - premiera modeli Bielik v3.1, Bielik-One i DFlash, wpis na LinkedIn, 10.11.2026
- Bielik 11B v3.1 Instruct na Hugging Face (odczyt 11.11.2026)
- UiPath - Connecting OSS models to AI Trust Layer, Automation Suite 2.2510 (odczyt 14.10.2026)
- Pomiar własny SNOK: MacBook Pro M4 Max 128 GB,
mlx_lm.server0.32, Bielik 11B v3.1 Instruct MLX 8-bit, 60 maili z Email Classifier PoC, 11.11.2026; test UiPath Automation Cloud (AI Trust Layer, Agent Builder), 12.11.2026 - Punkt odniesienia: Claude Sonnet 4.5 przez UiPath LLM Gateway, ten sam zestaw, dwa przebiegi 28.09.2026; basal-1.0 1.5B, pomiar własny 30.09.2026
- Pomiar zewnętrzny modeli decyzyjnych (praktyk spoza SNOK) na 402 polskich decyzjach, repozytorium system-1-ai, eksperyment 07 (16.10.2026)